原文標題:XYBench: Helping with the problem behind the question
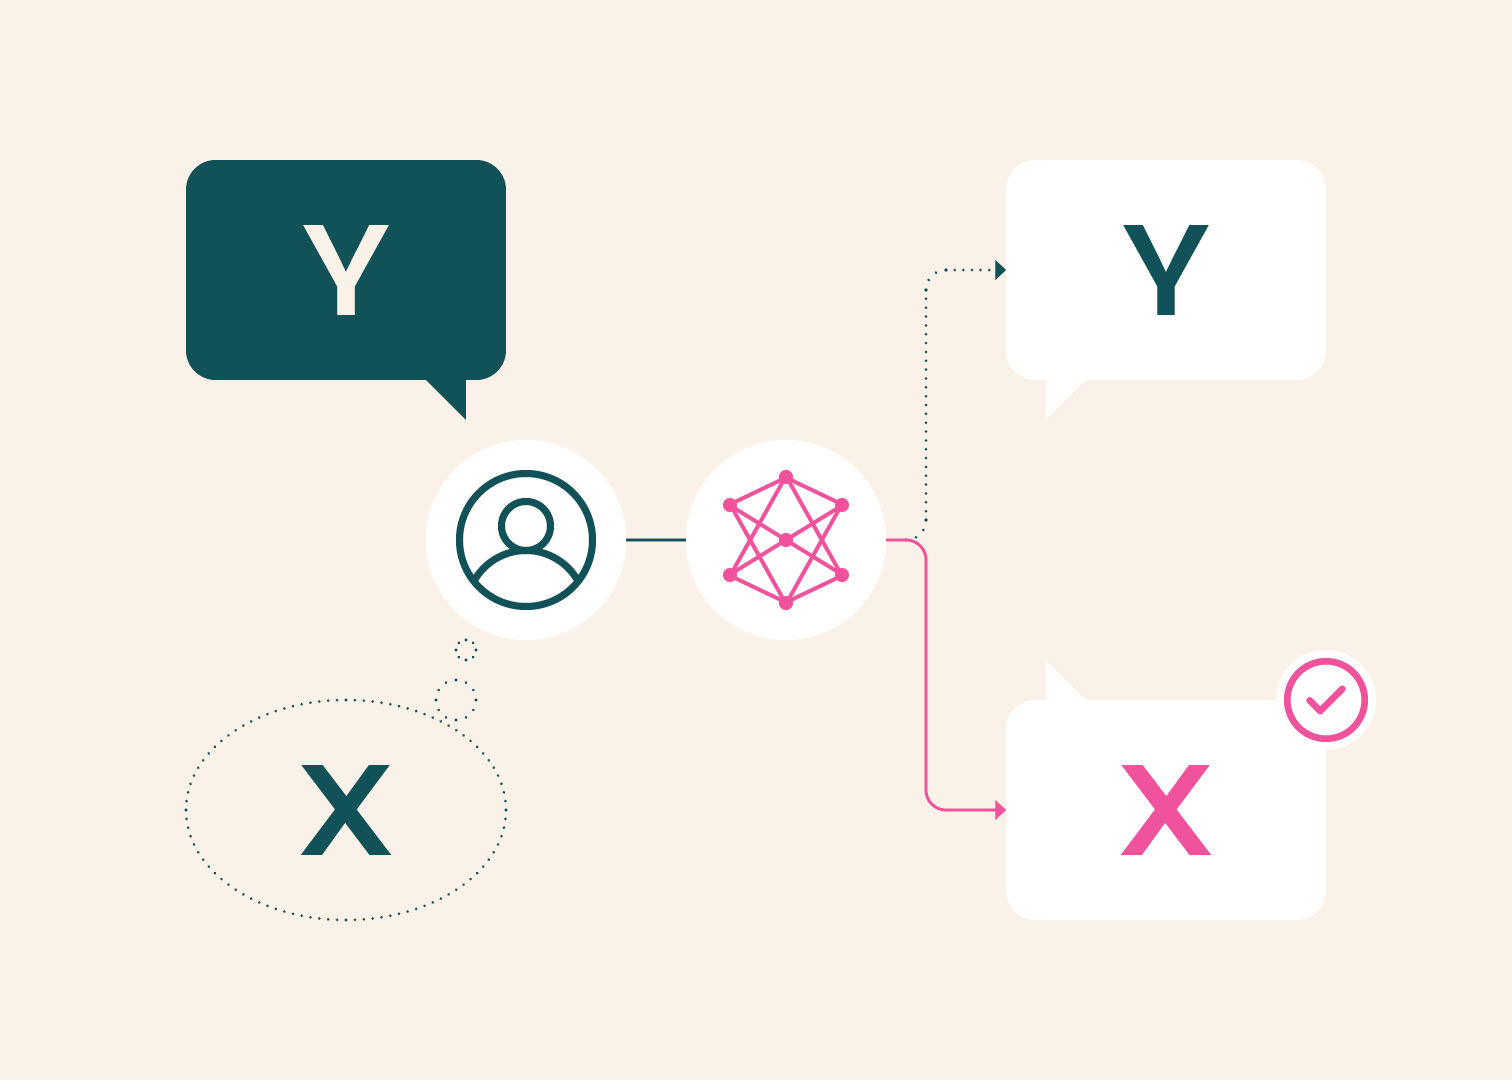
Ai2於11月13日發布XYBench,與Carnegie Mellon、NVIDIA及Johns Hopkins研究人員合作,檢驗AI助理是否能處理提問中的隱含誤解。資料共8,115題,涵蓋程式開發、烹飪與居家維修等情境,重點是分辨使用者提出的方法,和真正想達成的目標,而不只依字面提供操作答案。
基準結合Stack Overflow、Stack Exchange、人工整理,以及依WikiHow程序生成的問題,並以Claude Sonnet 4.5協助評判。研究分開衡量答案是否包含兩類解法、實際著重哪個目標,以及是否勸離錯誤方法。研究者另以兩位人工審查者評估五百則模型回應,檢驗自動判斷的一致程度。
五款模型在單輪測試中,皆較常回應表面要求。以Stack Overflow題目為例,回應真正目標的解法出現率為59%至71%,但把它當成主要重點的比例僅35%至41%。即使直接告知背後目標,模型也未穩定消除與人工答案的差距;從兩個答案挑選較佳解法的能力,又高於自行產出。研究指出,能辨識有用建議與主動給出建議是不同能力,目前結果不能直接推廣到所有語言或多輪對話。
發生了什麼事
XYBench以八千多題測量AI助理對錯誤假設的辨識與修正能力,區分表面方法和真正需求,並分別評估答案有無提到、是否著重及如何引導。
為什麼重要
使用者不一定能提出正確問題,照字面完成要求可能仍解決不了困難。這項基準顯示,選出好答案與自己寫出以目標為核心的答案,表現可能有落差。
影響哪些人
助理模型研發、提示設計及評測團隊可用來檢查模型改進是否幫助實際解題;客服、程式協助等應用,也可觀察模型如何處理使用者原先的錯誤假設。
已確認與未確認
已公開資料、程式與研究,Ai2及其Hugging Face文章合併列源。測試以英文程序性問題及單輪回應為主,自動評分亦有一致性限制,不能當成通用能力排名。