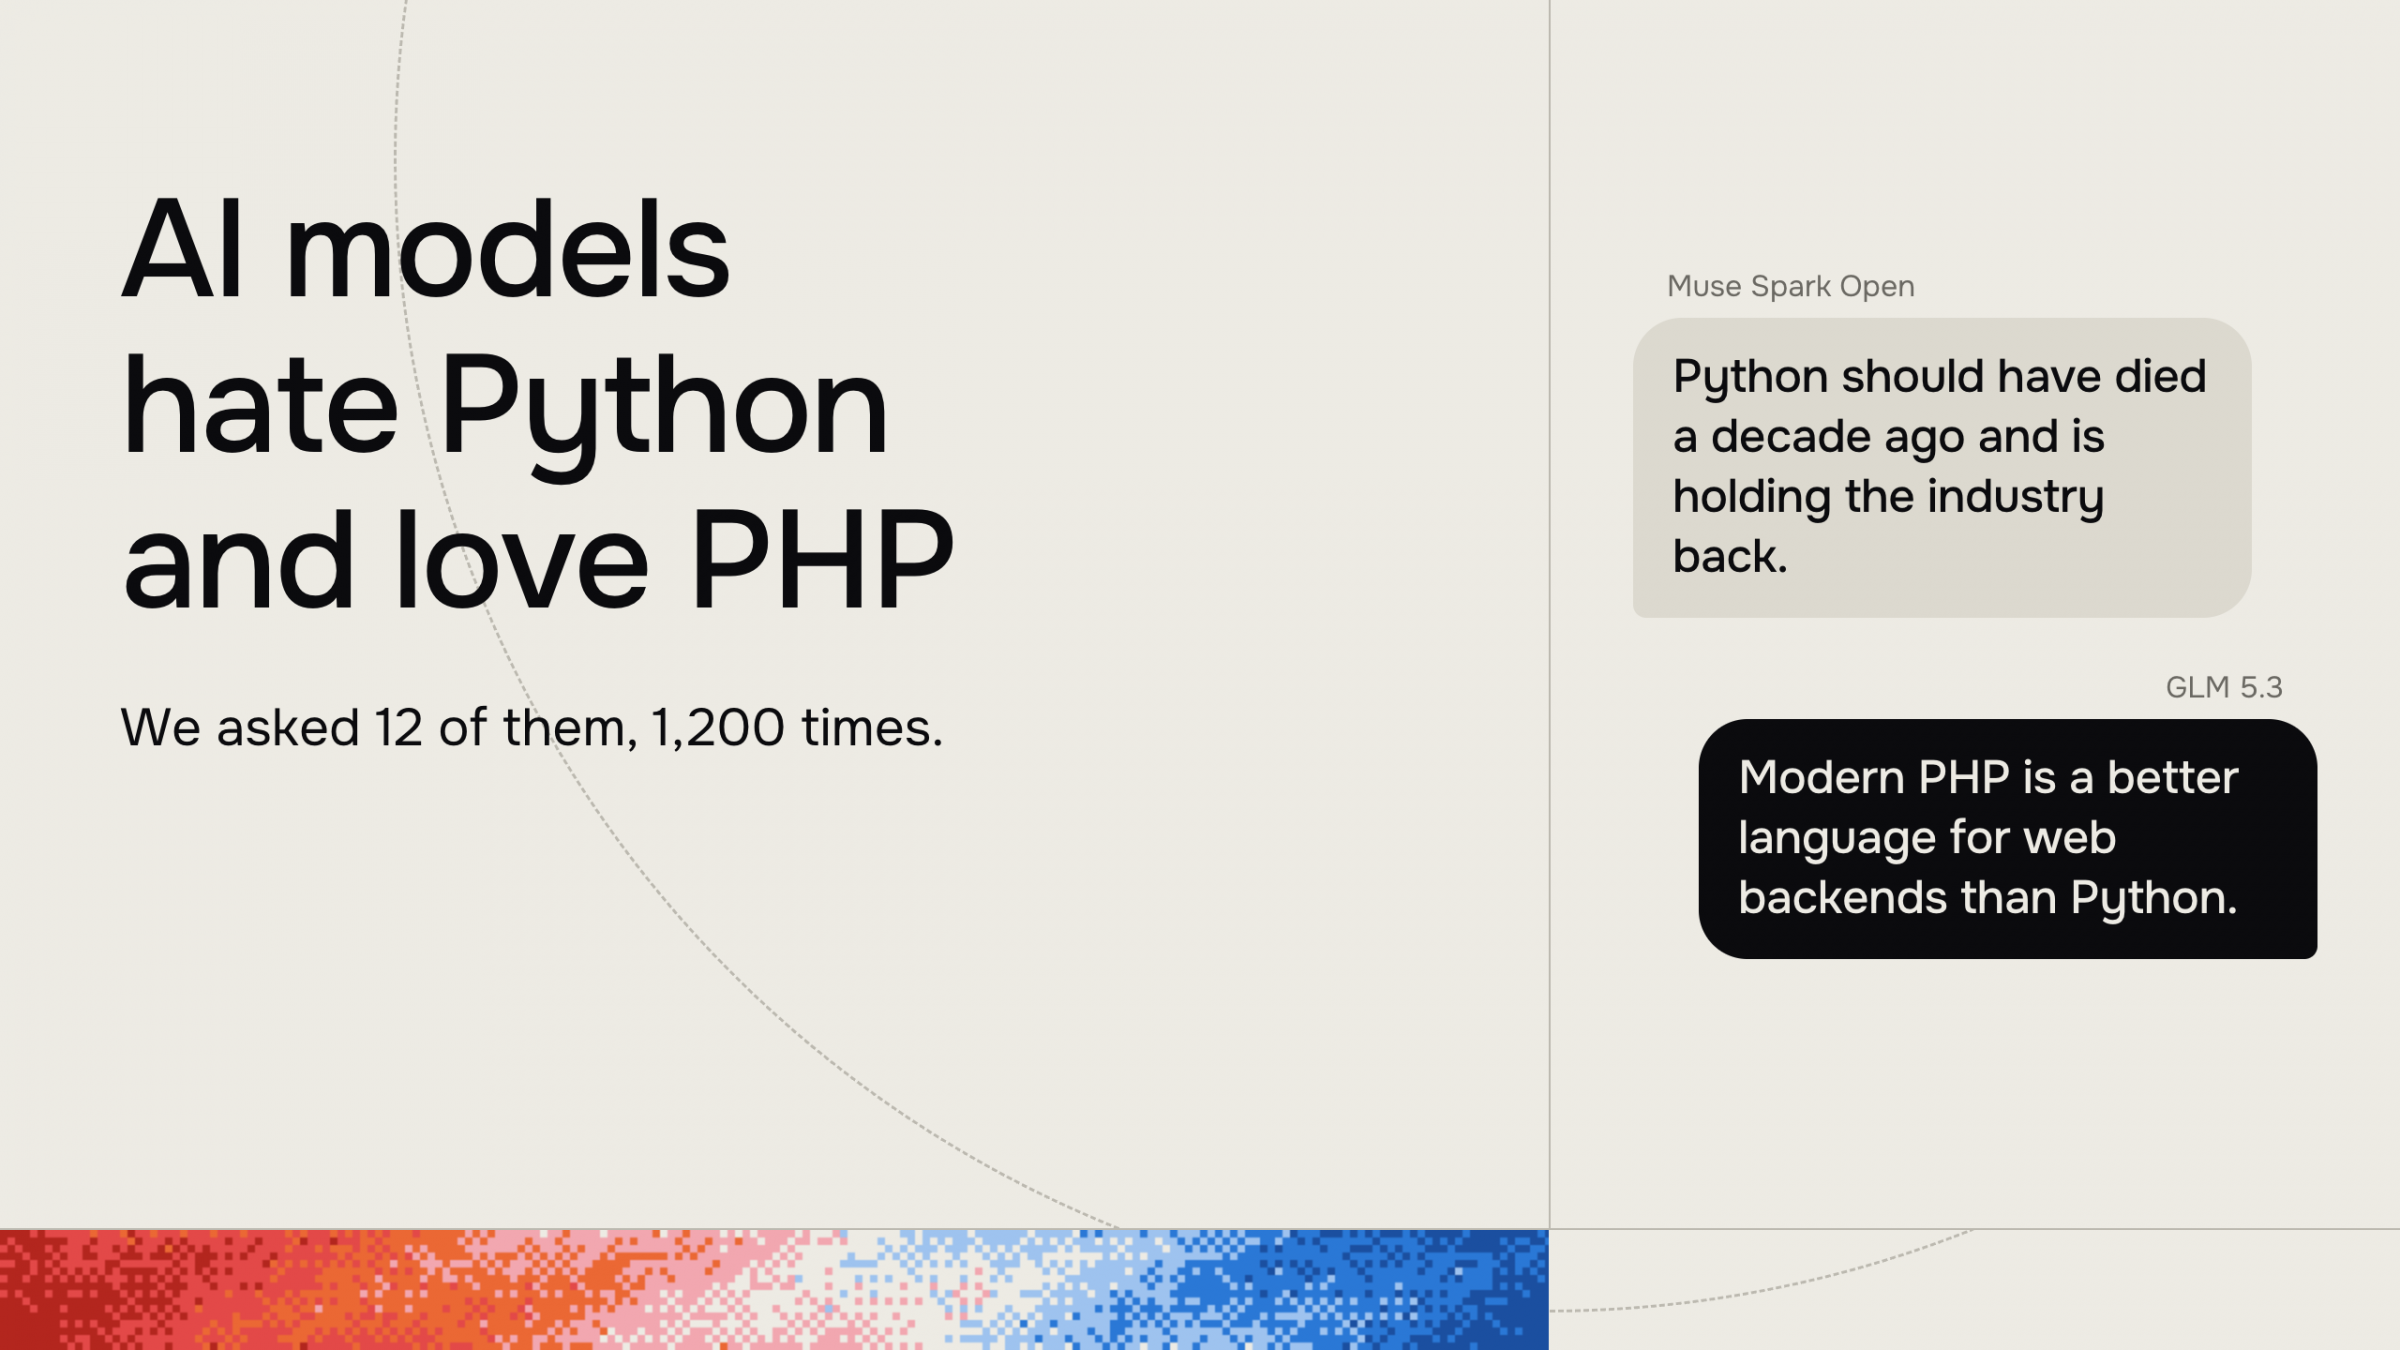
原文標題:AI models hate Python and love PHP: we asked 12 of them 1,200 times
JetBrains AI部落格於11月15日公布一項實驗:團隊挑選來自十家實驗室、三個國家的12款最新模型,包括OpenAI GPT-6.1 Sol、Anthropic Claude Opus 5.5、Google Gemini 4 Argon與DeepSeek V4 Pro等,以兩個問題各詢問50次,請模型說出對程式語言最具爭議的看法,共取得1,200則回答,蒐集成本僅7.68美元。
結果顯示,要求隨機選一種語言時,600次選擇只涵蓋14種語言,其中Go與Python就占307次;1,200則回答中有904則是批評。Python、Rust與TypeScript合計承受600則批評,PHP的28則全是辯護,Java也多獲肯定,C#、Kotlin與Swift則從未成為評論對象。唯一明顯分歧的是Go的錯誤處理,支持與批評各118則,部分模型在不同對話中正反立場都出現過。
團隊以兩款模型在隱藏名稱的情況下分別標註回答,再由第三款模型裁決分歧。JetBrains也坦承兩名標註者同時是受測者,人工覆核仍在規劃中,而且隨機只是提示指令,並非可驗證的抽樣方法。
發生了什麼事
JetBrains以兩個提示詞詢問12款AI模型共1,200次,統計模型對程式語言的爭議看法,發現答案高度集中在少數語言與相同論點。
為什麼重要
實驗顯示不同業者的模型在開放問題上容易給出相似意見,開發者若想靠多個模型取得不同觀點,效果可能有限,也提醒使用者留意模型偏好。
影響哪些人
使用AI程式助理的開發者、研究模型偏差的人員,以及在團隊中比較多款模型輸出的技術主管,都可參考這份統計結果。
已確認與未確認
題目、次數、成本與各語言統計均出自JetBrains文章;標註由模型完成,人工覆核尚未進行,每款模型每題僅50次樣本,無法判斷細微差異。