原文標題:NVIDIA Unveils Minerva to Bring End-to-End Observability for AI Factories
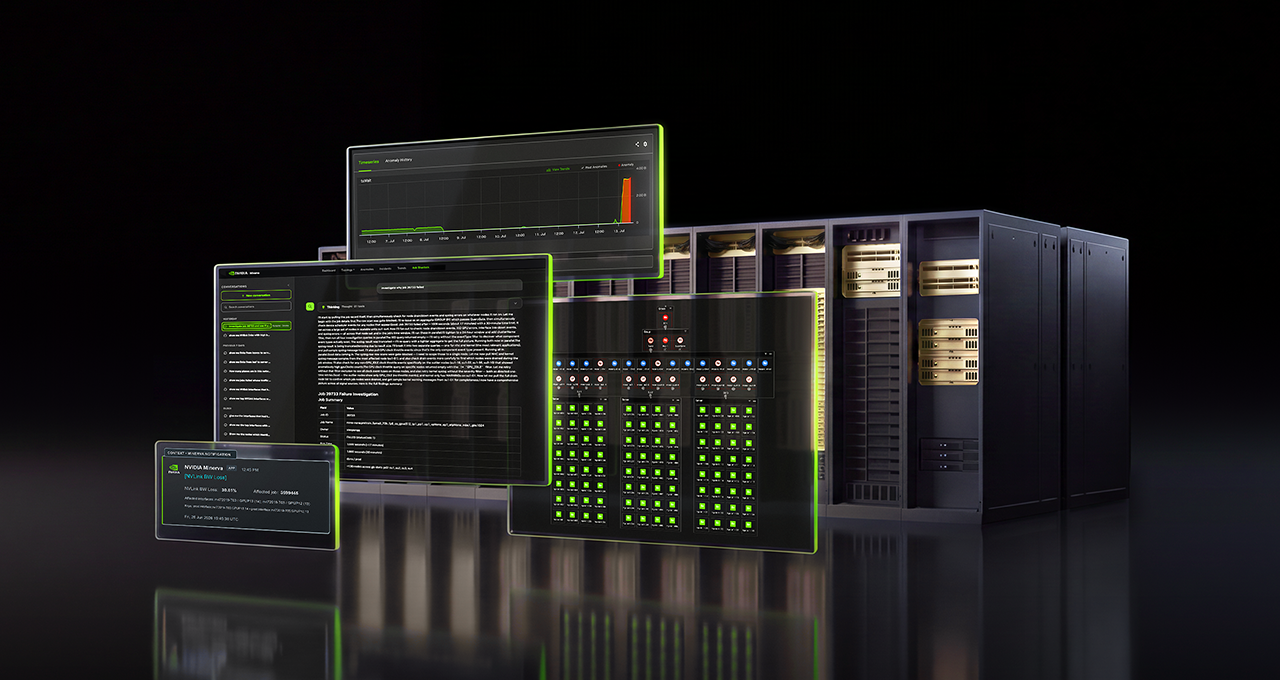
NVIDIA 於 10 月 22 日公布 Minerva,定位為面向大型 AI 工廠的 AIOps 營運平台。相較把伺服器、網路、儲存與 AI 工作分開監控的傳統工具,Minerva 目標是讓維運人員在同一個介面觀察基礎設施狀態與模型訓練、推論作業,將零散的警報整理成可以追查的事件。
平台會收集 NVIDIA GPU、SuperNIC、交換器、纜線、儲存裝置、工作排程器與 AI 工作負載的遙測資訊,再依設備與工作之間的關係建立動態知識圖譜。例如訓練作業速度下降時,系統可沿著拓樸追查異常發熱的 GPU、網路設備或效能降低的 NVMe 儲存裝置,而不是只呈現個別硬體的警示。
NVIDIA 表示,Minerva 每小時可分析數十億個資料點,結合監督式與非監督式機器學習辨識偏離正常狀態的行為、預測可能的故障,並把同一根本原因衍生的大量警報合併。內建 AI 助理可依即時遙測資料回答自然語言查詢,提供處理建議;管理員可保留人工核准,也能透過基礎設施 API 與外部系統連接自動化流程。
公司將 AI 工廠產出衡量指標稱為 yield,包含 GPU 可用時數、goodput、叢集正常運作時間與 token 產量。Minerva 著重於延長作業中斷間隔、縮短修復時間及減少無效告警,但原文未公布可供不同資料中心直接比較的統一效能增幅。
在導入方面,IREN 已被列為使用 Minerva 的合作夥伴;Aolani、Bitdeer AI、IBM、Jio、Lambda、Quake AI 與 Tesla 規劃部署。Dell Technologies、Lenovo 及 Supermicro 也將在各自的 AI 工廠營運產品組合中提供 Minerva。公告沒有揭露授權價格、各客戶的正式啟用日期或支援所有第三方硬體的完整清單。
發生了什麼事
NVIDIA 正式推出 Minerva,將 AI 工廠的硬體拓樸、遙測訊號及 AI 作業表現整合到同一套 AIOps 分析平台。
為什麼重要
大型 GPU 叢集可能因單一元件退化拖慢整個訓練工作;跨設備關聯分析能幫助維運團隊減少定位故障的時間,但實際效益仍須看部署環境。
影響哪些人
主要涉及雲端服務商、AI 資料中心營運商、叢集管理人員與採購 AI 工廠解決方案的企業;Dell、Lenovo、Supermicro 也列入供應合作。
已確認與未確認
已確認平台功能、部分已使用與計畫部署的合作夥伴;未公布公開定價、全部硬體相容性、客戶全面上線時程或可獨立重現的跨環境改善百分比。