原文標題:Deep dive into Azure Maia 300 architecture
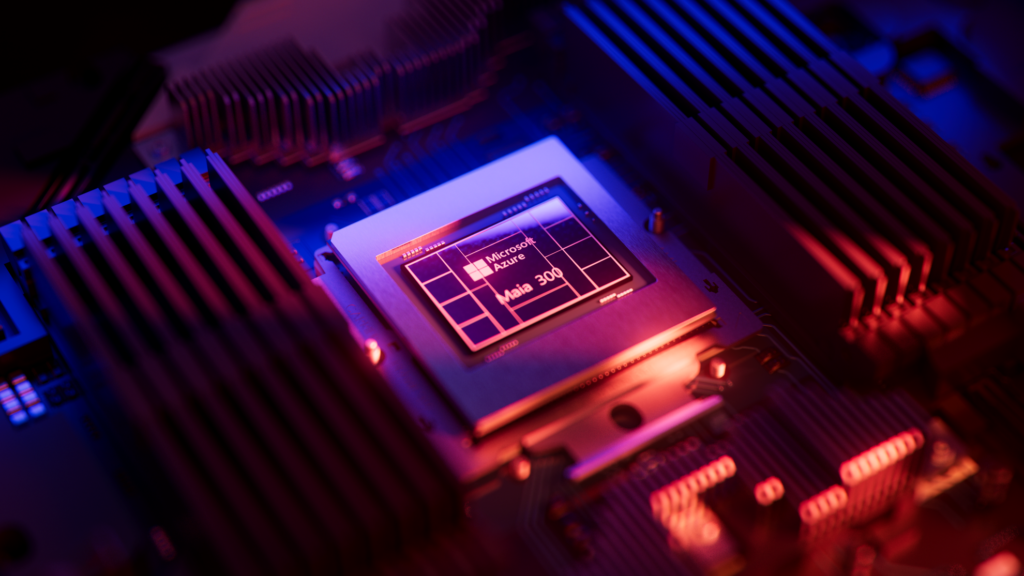
Microsoft 在 10 月 12 日公開 Azure Maia 300 的系統架構,將晶片、軟體、網路、機櫃供電與資料中心散熱視為同一個推論平台設計。這款第三代 Maia 加速器特別針對長上下文、推理與多步驟代理工作負載,目標不是單純增加算力,而是降低模型產生每個 Token 時的資料搬移與能源消耗。
晶片採多晶粒架構,運算部分使用 TSMC N2P 製程,記憶體控制與輸入輸出則分置其他晶粒。單顆加速器配備八組 HBM4,合計 288GB 容量、18TB/s 記憶體頻寬;相較 Maia 200,官方宣稱頻寬提升 2.5 倍、容量增加 33%。軟體可依運算區域調整資料位置,並利用低精度格式減少記憶體負擔。
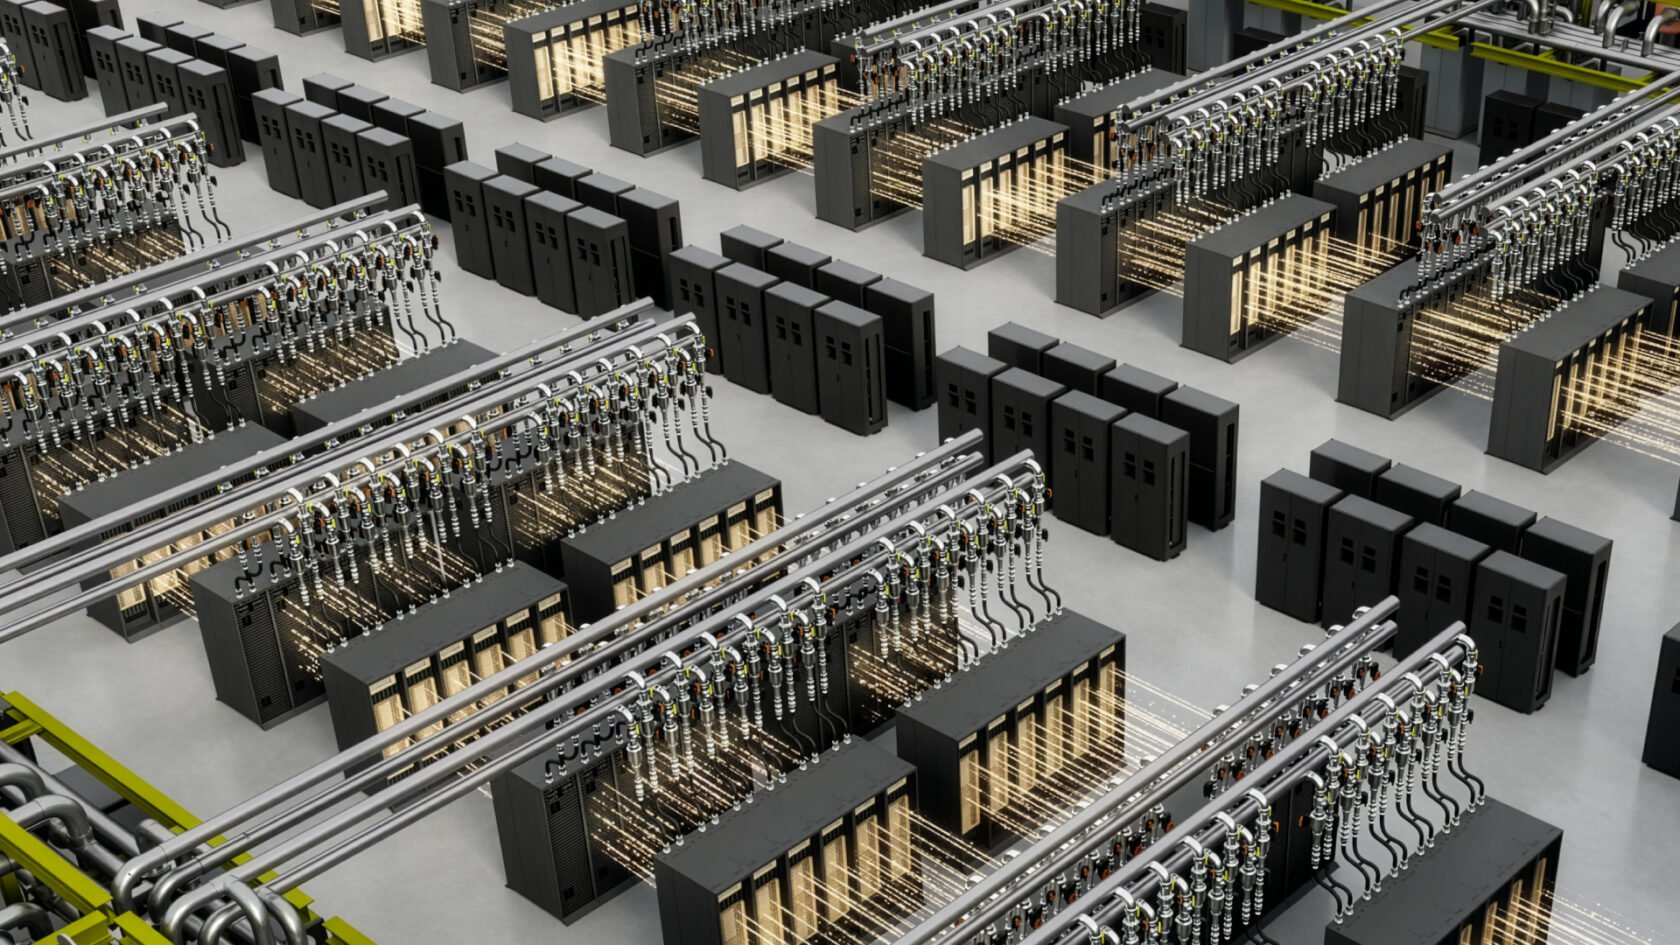
在機櫃層級,Maia 300 將 96 顆加速器裝入 24 個四加速器托盤,整櫃功率為 167kW。第二層光互連可把最多 128 個機櫃串成 12,288 顆加速器的 Superpod,讓不同機櫃之間使用同一套通訊模型。液冷負責移除機櫃超過八成的熱負載,其他元件仍可搭配氣冷。
Microsoft 表示,在完整 96 顆加速器配置下,Maia 300 的機櫃級 Token 吞吐量最高可達 Maia 200 的七倍,單位瓦特效能超過 2.5 倍。這些是官方以特定系統配置提出的比較,不等同於所有模型或客戶實際工作負載都會獲得相同增幅。
發生了什麼事
Microsoft 發表 Maia 300 推論平台的完整架構,涵蓋 HBM4、TSMC N2P 多晶粒晶片、96 加速器機櫃與可擴充至 12,288 顆的跨機櫃網路。
為什麼重要
AI 服務成本除了晶片運算速度,還取決於記憶體頻寬、網路延遲與能源效率;系統級設計將直接影響大規模推論的資源利用率。
影響哪些人
主要關係到 Azure 的大型模型服務、雲端 AI 開發者與資料中心基礎設施團隊,尤其是需要長上下文及多代理併發推論的應用。
已確認與未確認
官方已揭露記憶體、機櫃、網路與相對效能數據;尚未公布一般客戶的獨立租用價格、完整區域上線時程或第三方實測成績。