原文標題:Your Experts Have Partners. There's HOPE for Keeping Them Together
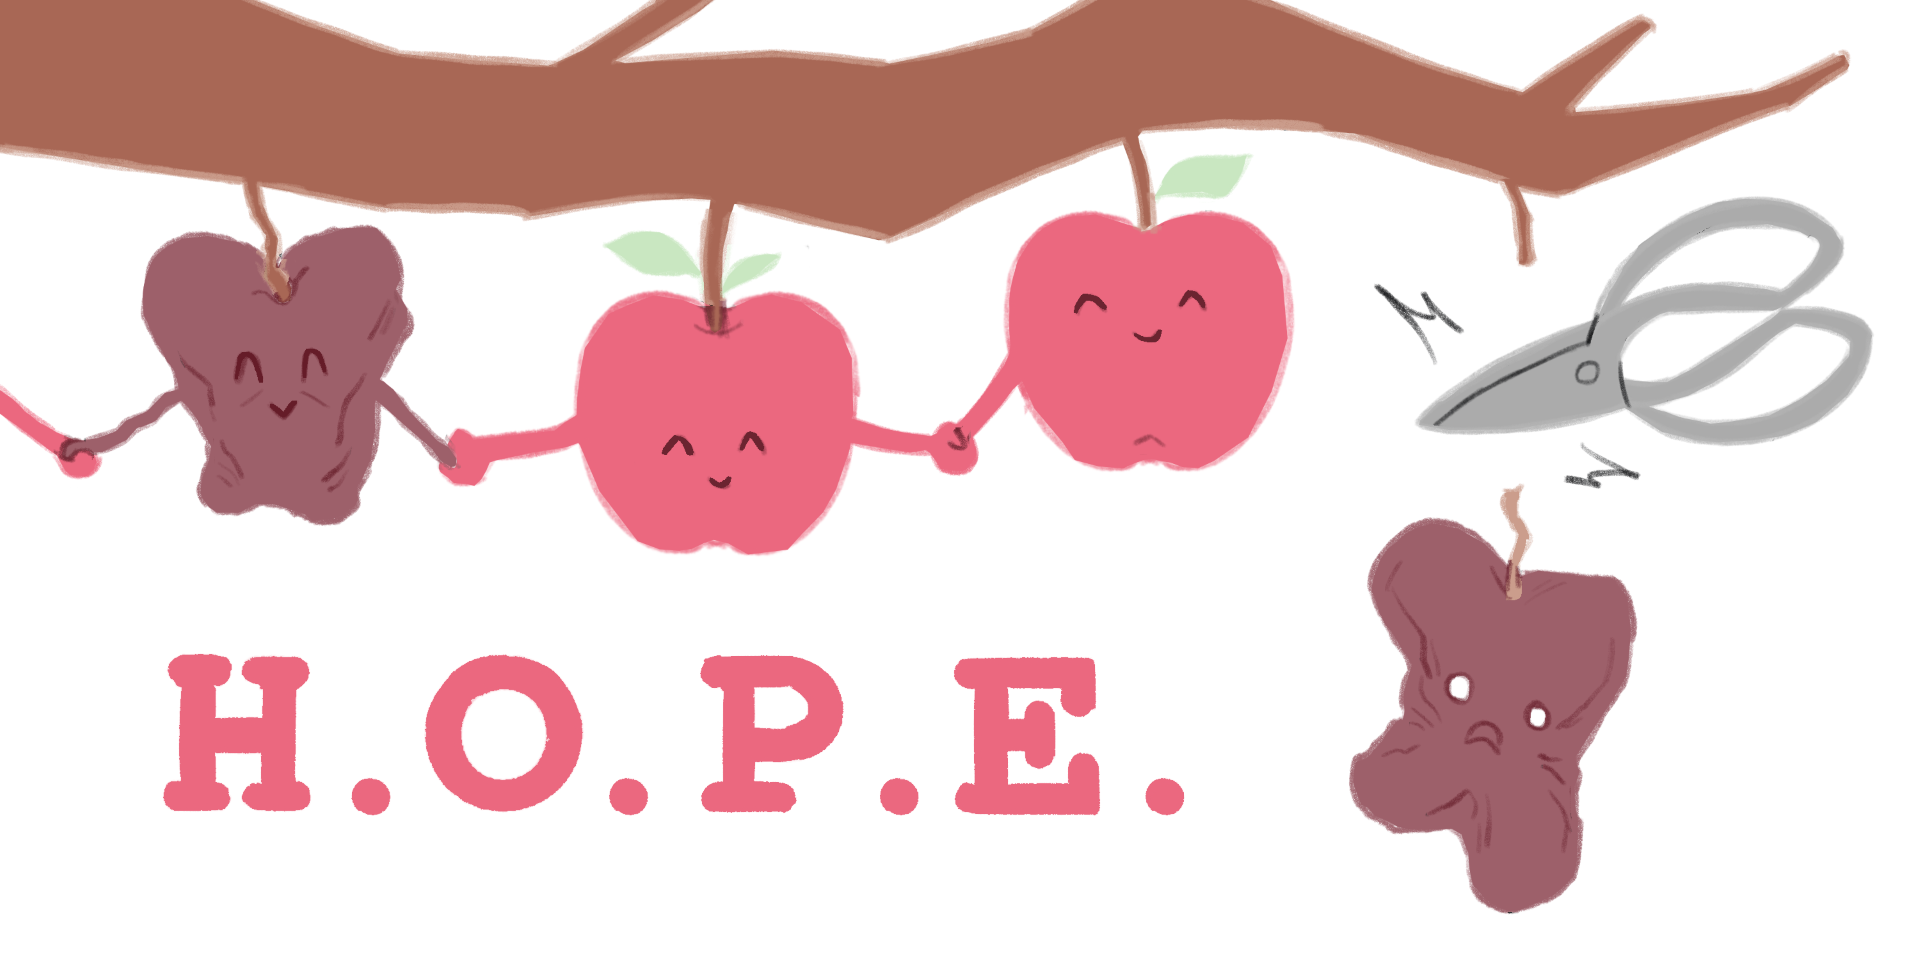
Amazon 研究團隊於 11 月 9 日在官方 Hugging Face 組織文章介紹 HOPE,完整名稱為 Higher-Order Pruning of Experts。它針對混合專家模型的記憶體負擔,選擇永久移除部分專家,讓模型即使每次只啟用少量專家,也不必在推論時保留全部原始參數,並可與量化搭配使用。
常見方法會分別替每個專家評分,HOPE 則把經常共同啟動的專家之間的互動納入,利用校準資料建立成對關係,再求解剪枝集合。團隊認為,單獨看似不重要的專家,可能支援另一個關鍵專家,忽略這種合作關係會在大量刪除時放大誤差。官方表示,在移除百分之五十專家的測試中,HOPE 取得較佳平均排名,部分程式智慧體任務也優於比較方法。
團隊同時公開程式及 Python API,包含校準、求解與輸出剪枝模型的流程,輸出可供既有推論框架載入。不過其優勢主要出現在百分之四十至五十等較高剪枝率;低剪枝率時,其他方法仍可能具有競爭力。HOPE 目前逐層處理,尚未完整納入跨層互動,三個以上專家關係也不在目前成對估計的範圍,實際效果需依模型與任務測試。
發生了什麼事
Amazon 團隊介紹 HOPE,透過校準資料估計專家間的成對關係,再選擇剪枝集合,以降低混合專家模型儲存與常駐記憶體需求,並公開相關程式。
為什麼重要
MoE 雖只啟用部分專家,全部權重仍可能占用大量記憶體。剪枝若同時考慮合作關係,有助降低移除專家後的誤差,但效果依模型與比例而變。
影響哪些人
需要部署大型 MoE 模型的推論平台與研究團隊,可評估記憶體節省及品質折衷;應使用接近真實任務的資料校準,避免只依單一基準決策。
已確認與未確認
已公開方法與工具,較高剪枝率的優勢為官方測試結果。低剪枝率未必領先,跨層及更高階互動仍有限制,不能推定任意模型都可無損減半。