原文標題:More Performance From Every Byte: How Full-Stack Codesign Solves AI’s Memory Challenge
NVIDIA 於 2026 年 11 月 5 日發表深度技術文章,解析如何透過「全棧協同設計(Full-Stack Codesign)」解決大型 AI 模型與智慧體工作負載引發的 GPU 記憶體容量與頻寬瓶頸。隨著前沿模型參數規模突破數兆個,加上 AI 智慧體在多輪工具呼叫與檢索增強生成(RAG)過程中需維持高達 300 萬個 Token 的上下文軌跡,存放模型權重與 KV 快取的 GPU 高頻寬記憶體(HBM)正面臨前所未有的空間競爭與成本壓力。
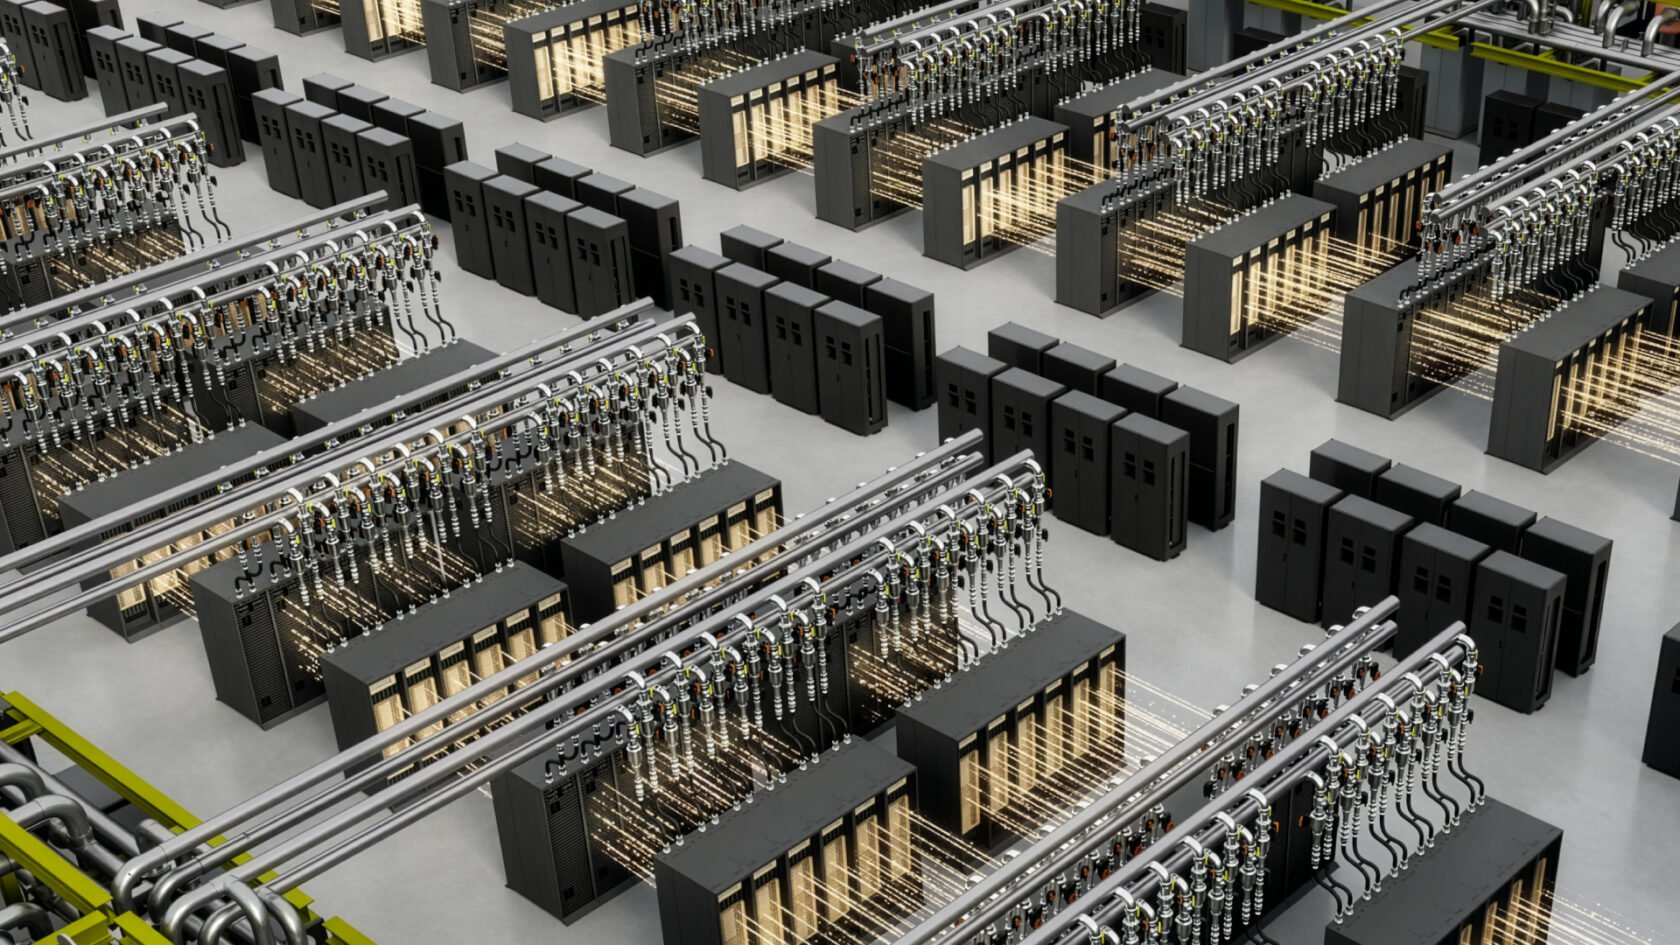
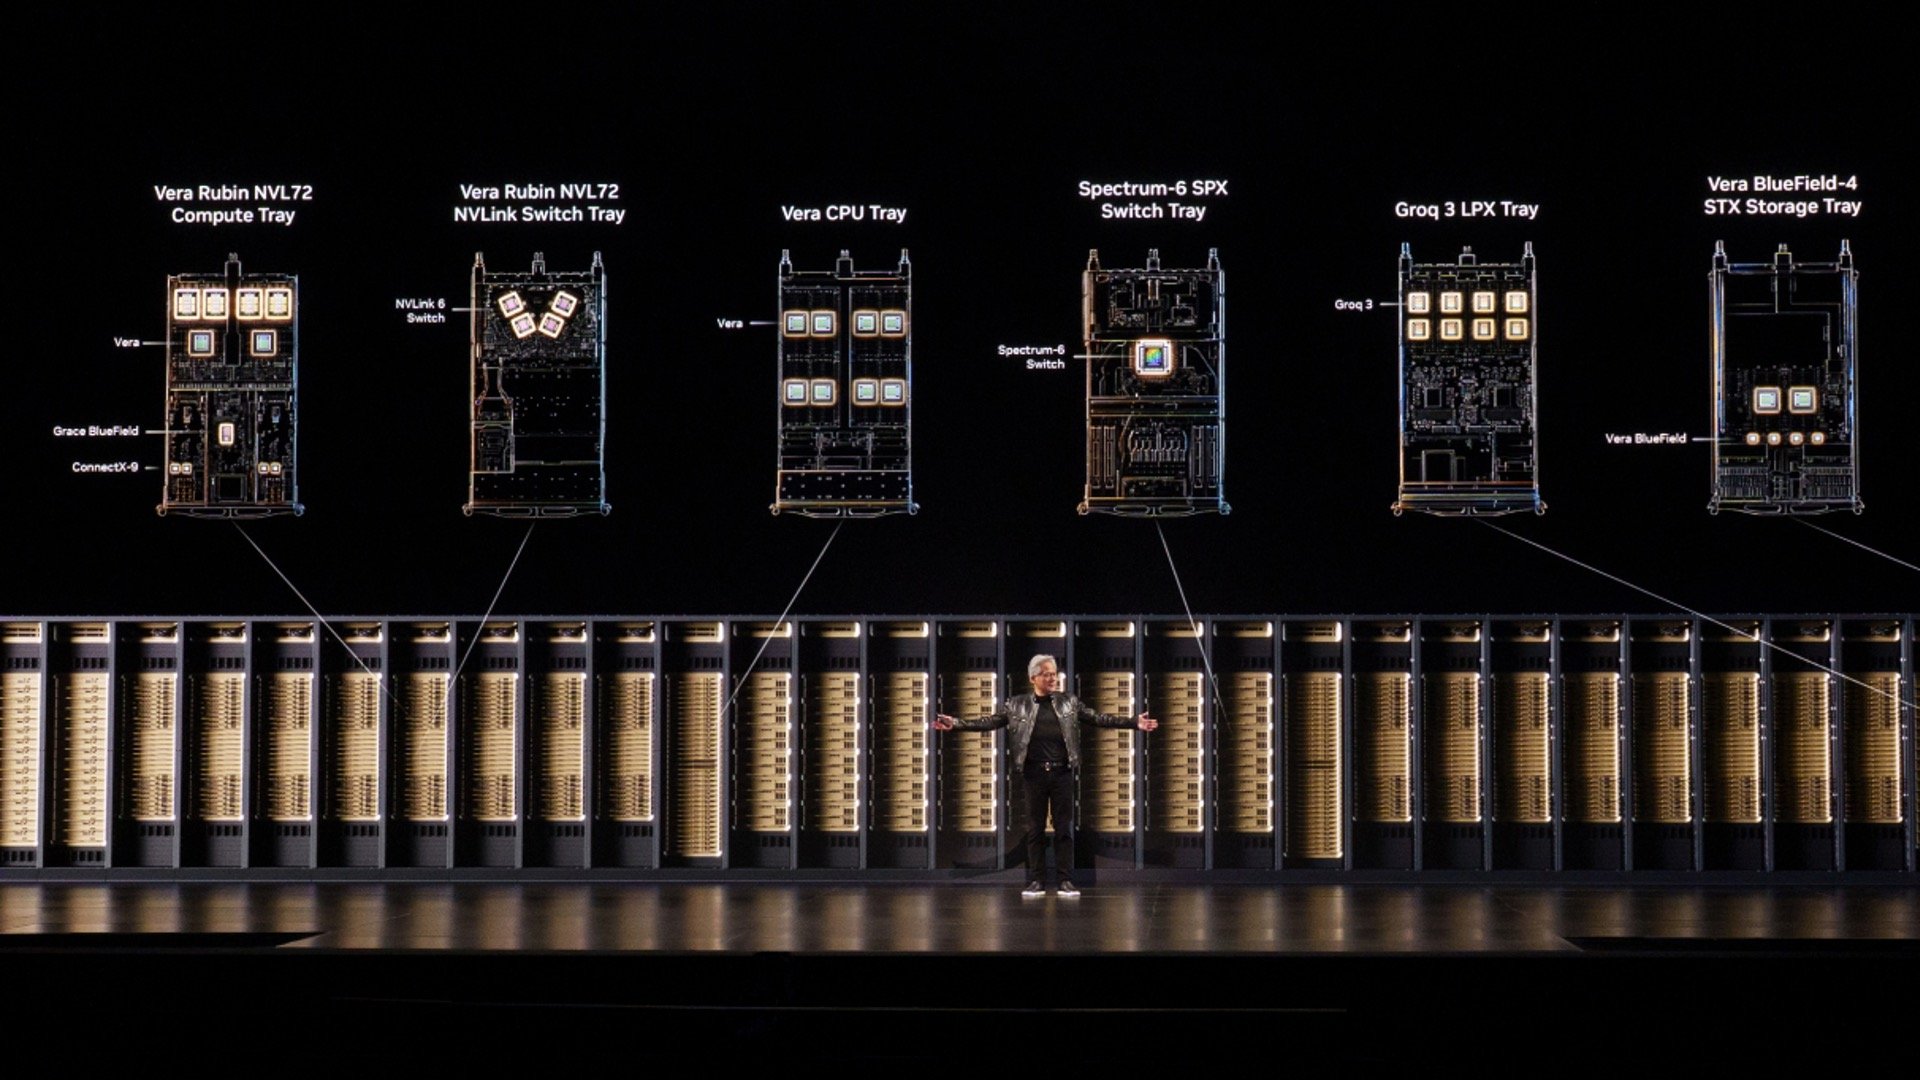
NVIDIA 指出,儘管公司率先將 HBM3e 與 HBM4 導入加速運算堆疊,但單純在 GPU 上堆疊更多 HBM 並非唯一解方,因為容量必須搭配足夠的傳輸頻寬與完整的記憶體階層。在 AI 工廠中,GPU HBM 下方依序連接著 CPU 記憶體、本機 SSD 與共享儲存設備,透過將 GPU、CPU、高速網路、儲存與軟體堆疊共同設計,系統能縮小資料體積、將快取精準配置於適當階層,並在 GPU 需要運算前預先調度到位。
這種跨層協同設計帶來了顯著的效能躍升:從 NVIDIA Blackwell Ultra 世代演進至新一代 Vera Rubin 平台,單顆 GPU 的 HBM 記憶體容量雖然僅增加約 3%,但在 SemiAnalysis AgentX 基準測試中,每美元所能產出的智慧體推論吞吐量(Agentic Throughput per Dollar)卻大幅提升了高達 30 倍,展現極致的每位元組使用效率。
發生了什麼事
NVIDIA 詳細說明其針對 AI 工廠記憶體階層(HBM、CPU 記憶體、SSD 與共享儲存)的全棧協同設計策略,並公布 Vera Rubin 對比 Blackwell Ultra 的 30 倍成本效益提升數據。
為什麼重要
在 HBM 供應吃緊且價格高昂的背景下,透過軟硬體協同調度 KV 快取與記憶體階層,能在僅增加 3% HBM 容量的情況下實現 30 倍智慧體推論效益。
影響哪些人
部署數兆參數模型與長上下文 AI 智慧體的雲端服務商、AI 實驗室,以及規劃新一代資料中心儲存與記憶體架構的基礎設施團隊。
已確認與未確認
已確認從 Blackwell Ultra 到 Vera Rubin 的 HBM 容量增幅(約 3%)與 SemiAnalysis AgentX 每美元吞吐量提升倍數(最高 30 倍);個別客戶工作負載的實際增幅仍視快取命中率而定。