原文標題:Dharma Field Extractor: Any Document In, Structured Fields in JSON Out
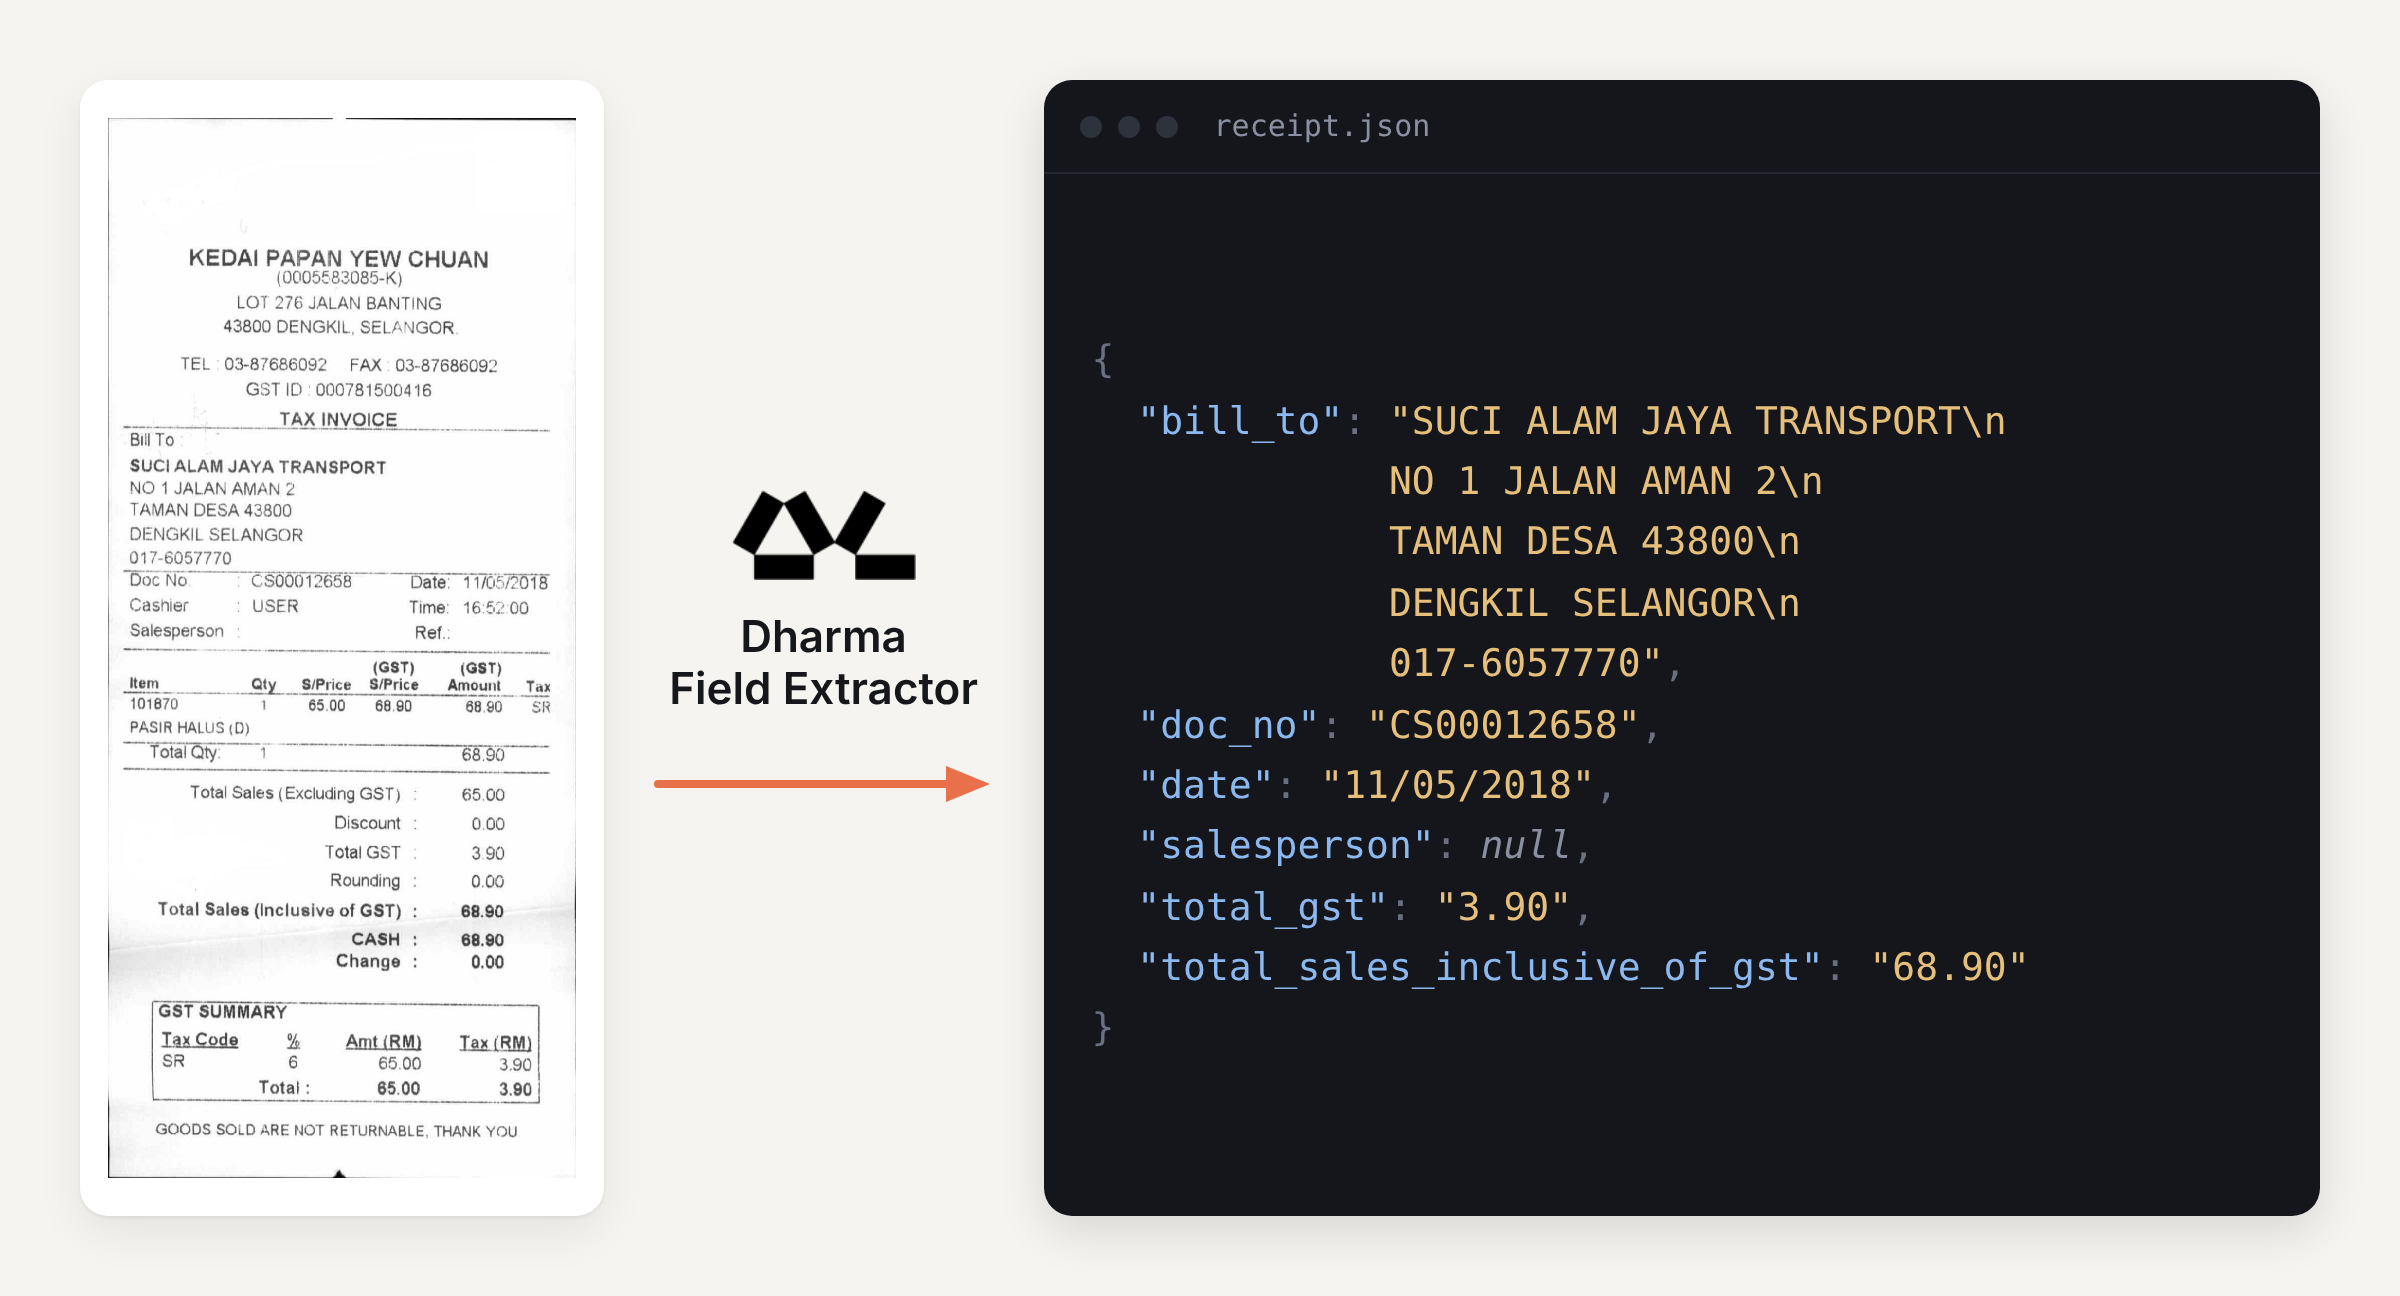
Dharma-AI於11月4日在官方Hugging Face組織介紹Field Extractor,將文件影像直接轉為結構化JSON。使用者可讓模型自行找出表單與表格欄位,也可指定完整結構、鍵名與字串、數字或布林型別;若文件沒有要求的內容,設計上應回傳null。與輸出整頁文字的OCR不同,這款模型聚焦發票明細、身分文件或合約等需要接到下游系統的欄位資料。
模型以20億參數DharmaOCR-LITE v1.1為基礎,使用43,384筆資料訓練LoRA,包含英文多領域、葡萄牙文巴西文件及部分其他語言。官方評測涵蓋546份文件、三種請求情境,共1,638個案例,同時評估欄位配對、字串相似度及JSON有效性。團隊主張在這項測試中優於比較的通用模型,成本也較低;不過自架成本以單張L40S的GPU時間估算,對照的API成本則依用量與公開價格計算,兩者不是相同報價方式。原文也明確說明這不是產品銷售價格。企業若要導入,仍應用自己的版型、語言及缺漏欄位測試,確認輸出結構與辨識錯誤如何進入人工覆核流程。
發生了什麼事
Field Extractor接收文件圖片,依開放或指定結構模式回傳JSON欄位,並以專用小模型處理型別、表格明細及文件中不存在的項目。
為什麼重要
企業常需要直接寫入系統的欄位,而非只有OCR全文。專用模型把辨識與欄位對應放在同一步,可減少後續規則處理,但仍需檢查錯誤。
影響哪些人
主要影響處理大量發票、表單、身分文件與合約的文件自動化團隊,以及需要自架部署、控制成本和輸出結構的企業開發者。
已確認與未確認
已確認模型與官方測試設計;優勢為開發團隊自行測量,GPU成本不等於商業售價,也不能推定任何文件都正確,仍需在實際資料驗證。